Serveurs de l'IA : le vrai trajet de votre prompt
Définition
Le trajet d'un prompt désigne le chemin physique parcouru par votre question entre votre écran et les serveurs de l'IA : ondes Wi-Fi, fibre de votre fournisseur, point d'entrée du service, câble sous-marin, puis puces de calcul dans un centre de données. La réponse refait le même chemin en sens inverse, morceau par morceau.
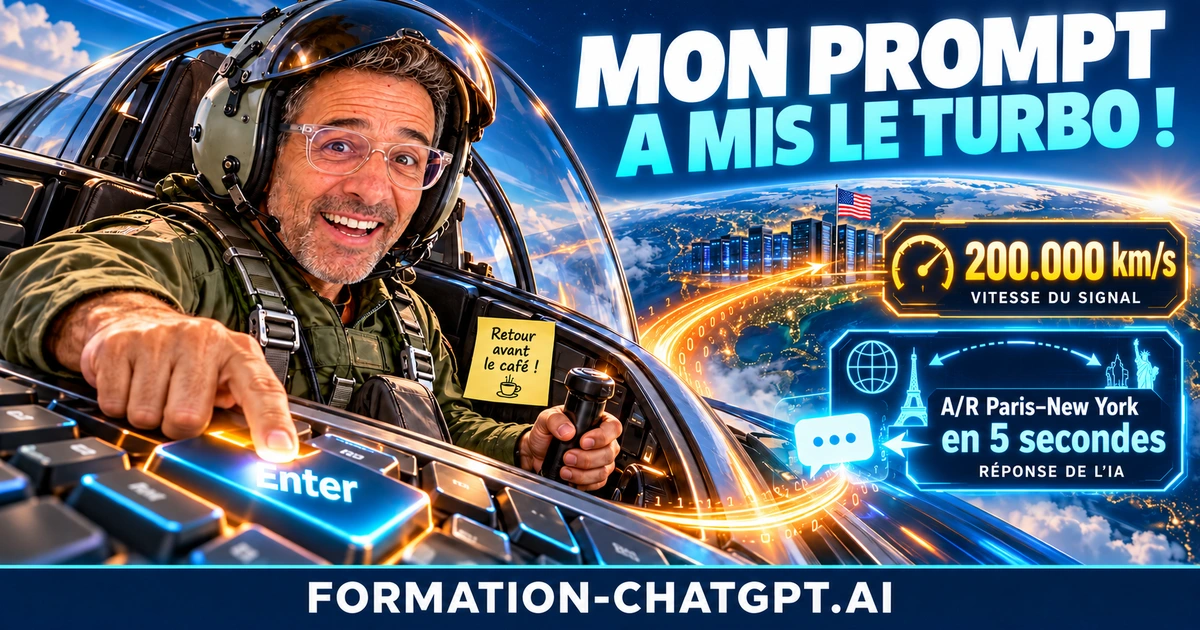
Quand vous écrivez à Claude depuis la France, votre prompt sort du réseau Orange à Paris en 15 millisecondes environ (mesure du 22 octobre 2026), traverse l'Atlantique par câble sous-marin en 33 ms environ, puis rejoint les serveurs de l'IA aux États-Unis. Le trajet réseau aller-retour pèse de l'ordre d'un dixième de seconde : le reste du temps d'attente, c'est le calcul du modèle.
En bref
| Critère | Détail |
|---|---|
| Trajet aller | Wi-Fi, box, réseau Orange, Cloudflare à Paris, câble transatlantique, centre de données |
| Mesuré jusqu'à Paris | 9 sauts, 14 à 17 ms aller-retour (22 octobre 2026) |
| Traversée de l'Atlantique | Environ 33 ms dans un sens pour 6 600 km de fibre (calcul) |
| Lieu du calcul | Très probablement aux États-Unis (Google Cloud, AWS, Microsoft Azure) |
| Étape la plus longue | Le calcul du modèle, token après token |
| Satellite ? | Non : 607 câbles sous-marins, 1,5 million de km de fibre (TeleGeography, 2026) |
| Puissance en jeu | Près de 500 000 puces Trainium2 et 1 million de TPU réservés par Anthropic |
| Énergie d'un prompt texte | 0,24 Wh (Gemini, Google) à 0,34 Wh (ChatGPT, annoncé) |
Sommaire
- Les chiffres qui interpellent
- Les 7 étapes du trajet
- Ma mesure : 9 sauts jusqu'à Paris
- Pourquoi Paris répond
- Câble ou satellite
- Où sont les serveurs
- L'énergie d'un prompt
- Dans le centre de données
- Combien de temps par étape
- Vos données et l'Atlantique
- 3 idées reçues
- Mesurer vous-même
- Questions fréquentes
Une demi-seconde. C'est à peu près le temps qui sépare l'appui sur Entrée de l'apparition des premiers mots de Claude ou de ChatGPT. Pendant ce laps de temps, votre question a quitté votre bureau, traversé un océan, réveillé des centaines de puces et fait le chemin inverse. J'ai voulu voir ce trajet de mes propres yeux : j'ai lancé des mesures réseau depuis mon poste et fait construire par Claude une simulation animée du parcours. Voici ce que j'en retiens, étape par étape, pour comprendre où travaillent vraiment les serveurs de l'IA.
"Un dirigeant sans IA, c'est un général sans cartes"
Quelques chiffres qui nous interpellent
Les chiffres du trajet d'un prompt donnent le vertige dès qu'on les aligne, du millième de seconde au million de puces.
| Chiffre | Ce qu'il mesure | Source | Cité par |
|---|---|---|---|
| 15 ms | Aller-retour entre mon poste et le portier parisien de claude.ai | Ma mesure tracert, 22/10/2026 | ATLANTICOM |
| 33 ms | Traversée de 6 600 km de fibre sous l'Atlantique, dans un sens | Calcul : lumière à 200 000 km/s dans la fibre | ATLANTICOM |
| 607 | Systèmes de câbles sous-marins en service dans le monde, plus 102 en projet | TeleGeography, 2026 | TeleGeography |
| 1,5 million de km | Longueur totale des câbles sous-marins en service | TeleGeography, début 2026 | FAQ TeleGeography |
| 14 | Systèmes de câbles transatlantiques en service | TeleGeography, 2026 | TeleGeography |
| 200 | Pannes de câbles sous-marins par an en moyenne, aux deux tiers causées par la pêche et les ancres | International Cable Protection Committee | TeleGeography |
| 500 000 | Puces Trainium2, ou presque, dans le projet Rainier construit par AWS pour Anthropic | AWS, octobre 2025 | Amazon |
| 1 million | TPU Google réservés par Anthropic, pour plus d'un gigawatt de capacité en 2026 | Anthropic, octobre 2025 | Anthropic |
| 50 milliards $ | Plan de centres de données d'Anthropic avec Fluidstack, au Texas et dans l'État de New York | Anthropic, novembre 2025 | TechCrunch |
| 0,24 Wh | Énergie médiane d'un prompt texte Gemini, 33 fois moins qu'un an plus tôt | Google, août 2025 | MIT Technology Review |
| 0,34 Wh | Énergie moyenne par prompt ChatGPT annoncée, sans méthode publiée | Sam Altman, juin 2025 | Blog de Sam Altman |
| 2,5 milliards | Prompts reçus chaque jour par ChatGPT | OpenAI, juillet 2025 | Axios |
| 415 TWh | Électricité consommée par les centres de données en 2024 (1,5 % du total mondial), 945 TWh attendus en 2030 | AIE, rapport Energy and AI, 2025 | AIE |
Ma lecture : le voyage d'un prompt se compte en millisecondes, l'infrastructure qui le reçoit se compte en gigawatts et en milliards de dollars. Le goulot n'est pas le câble, c'est la puce. Anthropic, de son côté, ne publie pas la consommation d'un prompt Claude.
Serveurs de l'IA : le trajet complet d'un prompt en 7 étapes
Le trajet d'un prompt vers les serveurs de l'IA suit sept étapes, de votre clavier jusqu'aux puces de calcul, puis retour.
- Chiffrement sur votre appareil. Le navigateur chiffre la question (TLS) puis la découpe en paquets de 1 500 octets au plus. Une question courte tient dans un ou deux paquets.
- Ondes Wi-Fi jusqu'à la box. Quelques mètres en radio, 5 à 6 ms aller-retour dans ma mesure.
- Fibre jusqu'au réseau du fournisseur. Le paquet devient lumière et rejoint le réseau national d'Orange.
- Sortie à Paris, chez Cloudflare. Le service qui protège claude.ai reçoit la connexion dans sa salle parisienne.
- Traversée de l'Atlantique. Le trafic rejoint la côte, puis un câble sous-marin jusqu'aux États-Unis.
- Calcul dans un centre de données. Découpage en tokens, lecture du prompt, puis génération de la réponse sur des accélérateurs (GPU, TPU ou Trainium).
- Retour au fil de l'eau. Chaque morceau de réponse repart dès qu'il est prêt et refait tout le chemin en sens inverse.
Retenez surtout ceci : les cinq premières étapes et la dernière sont quasi instantanées. La lenteur ressentie se loge presque entièrement dans la sixième.
Ma mesure : 9 sauts et 15 ms jusqu'à Paris
Le 22 octobre 2026, j'ai lancé un tracert vers l'adresse de claude.ai depuis mon ordinateur, sur une connexion Orange. La commande liste chaque routeur traversé et le temps d'un aller-retour vers chacun d'eux. Résultat : 9 sauts et 14 à 17 ms aller-retour jusqu'au dernier.
| Saut | Où | Opérateur | Aller-retour |
|---|---|---|---|
| 1 | La box, dans le bureau | Livebox | 5 à 6 ms |
| 2 | Premier routeur du fournisseur | Orange | 12 à 23 ms |
| 3 et 4 | Routeurs muets (ne répondent pas aux sondes) | Orange | non mesuré |
| 5 à 7 | Réseau national | Orange | 13 à 21 ms |
| 8 | Entrée du réseau Cloudflare | Cloudflare, Paris | 15 à 24 ms |
| 9 | Adresse publique de claude.ai | Anthropic, via Cloudflare à Paris | 14 à 17 ms |
Une mesure curl complète le tableau : 17 ms pour la résolution DNS, 33 ms pour ouvrir la connexion, 61 ms pour terminer la négociation du chiffrement et 78 ms pour recevoir le premier octet de réponse du portier. Au-delà de Paris, le traceroute ne voit plus rien : le trafic circule dans le réseau privé de Cloudflare, puis dans celui d'Anthropic.
Pourquoi le serveur qui répond à vos prompts est à Paris
Le serveur qui répond à Paris est un portier, pas le cerveau. Claude.ai, comme une grande partie du web, passe par Cloudflare, un réseau qui reçoit les connexions au plus près des utilisateurs, filtre les attaques et transmet ensuite la demande au vrai serveur. L'indice se lit dans les en-têtes de la réponse : CF-RAY: ...-CDG. La documentation de Cloudflare explique que ce suffixe désigne le centre qui a traité la requête ; CDG est le code de l'aéroport Roissy-Charles-de-Gaulle, utilisé pour nommer le site parisien.
Le chiffrement court de bout en bout entre votre appareil et ce portier. Orange voit passer des paquets, leur taille et leur destination, mais pas le texte de votre question.
"Ne travaillez plus comme hier dans un monde qui avance comme demain"
Câble sous-marin ou satellite : par où passe le prompt ?
Les prompts envoyés aux serveurs de l'IA traversent l'océan dans des câbles sous-marins, pas par satellite. Selon TeleGeography, la part du trafic international encore portée par satellite est très faible. Le réseau compte 607 systèmes de câbles en service en 2026, plus de 1,5 million de kilomètres au total, dont 14 systèmes transatlantiques ; la carte publiée par TeleGeography en montre la densité.
Ces câbles cassent aussi : environ 200 pannes par an en moyenne, aux deux tiers à cause de chalutiers et d'ancres. Personne ne le remarque, car le trafic se répartit sur plusieurs câbles à la fois.
Les câbles Dunant et Amitié, entre la France et les États-Unis
Les deux câbles transatlantiques les plus récents à atterrir en France sont Dunant et Amitié. Selon Next, Dunant, financé par Google, relie Saint-Hilaire-de-Riez en Vendée à la Virginie sur 6 600 km ; Amitié relie Le Porge, en Gironde, à Lynn près de Boston sur 6 800 km. Orange exploite la partie française des deux. Impossible en revanche de savoir quel câble précis emprunte une requête donnée : Cloudflare et Anthropic choisissent leurs routes.
À quoi ressemble un câble au fond de l'océan
Un câble transatlantique, en grande profondeur, se résume à quelques paires de fibres de verre dans un tube d'acier rempli de gel, entouré de torons de renfort, d'un conducteur en cuivre et d'une gaine isolante ; près des côtes, une armure d'acier le protège des ancres. Le cuivre alimente des répéteurs posés tous les 60 à 80 km environ, qui amplifient la lumière avant qu'elle ne s'éteigne. Au milieu de l'Atlantique, il repose à plus de 4 000 mètres sous la surface.
Et Starlink ?
Une connexion Starlink envoie bien le prompt vers un satellite en orbite basse, mais le signal redescend vers une station au sol en Europe, puis reprend les mêmes câbles. Les satellites géostationnaires, à 36 000 km d'altitude, ajouteraient près d'une demi-seconde à chaque aller-retour : aucun service d'IA ne compte sur eux.
Où sont les serveurs de Claude et de ChatGPT ?
Les serveurs de l'IA qui calculent les réponses de Claude se trouvent très probablement aux États-Unis. Anthropic ne publie pas quel centre de données traite quelle demande ; la répartition change avec la charge. Les fournisseurs, eux, sont connus : Google Cloud (puces TPU), Amazon Web Services (puces Trainium, dont le projet Rainier dans l'Indiana) et Microsoft Azure (GPU Nvidia). Anthropic construit aussi ses propres centres avec Fluidstack au Texas et dans l'État de New York, un plan annoncé à 50 milliards de dollars avec des sites prévus courant 2026.
OpenAI ne publie pas davantage l'emplacement exact de ses machines. ChatGPT s'appuie notamment sur Microsoft Azure et sur les campus Stargate, dont le premier se trouve à Abilene, au Texas.
Pourquoi les serveurs de l'IA ne sont pas en France
Les puces d'IA sont rares, chères et gourmandes en électricité. Le projet Rainier réunit à lui seul près d'un demi-million de puces Trainium2, et la réservation de TPU Google par Anthropic dépasse un gigawatt de capacité. Regrouper de telles machines dans quelques campus géants coûte moins cher que de les disperser près de chaque utilisateur. Le réseau, lui, coûte très peu de temps : 33 ms pour franchir l'océan, quand le calcul en demande des centaines.
Combien d'énergie consomme un prompt ?
L'énergie d'un prompt texte se mesure en fractions de wattheure. Google a publié en août 2025 une médiane de 0,24 Wh pour un prompt Gemini, avec 0,26 millilitre d'eau, soit environ cinq gouttes, et une consommation divisée par 33 en un an. Sam Altman a annoncé 0,34 Wh pour un prompt ChatGPT moyen, sans détailler sa méthode. Anthropic ne publie pas de chiffre équivalent pour Claude.
Multiplié par les volumes, le total change d'échelle : ChatGPT recevait déjà 2,5 milliards de prompts par jour en juillet 2025, et l'Agence internationale de l'énergie estime que les centres de données ont consommé 415 TWh en 2024, avant un quasi-doublement attendu d'ici 2030. Ces chiffres concernent le texte : une image ou une vidéo générée coûte bien davantage.
Que se passe-t-il dans le centre de données ?
Le centre de données réalise quatre opérations entre l'arrivée du prompt et le départ du premier mot.
Accueil et contrôles
Le serveur d'entrée déchiffre la requête, vérifie le compte et l'abonnement, applique des filtres de sécurité et place la demande dans une file d'attente. Aux heures de pointe, cette file explique une partie des réponses qui tardent à démarrer.
Découpage en tokens
Le modèle ne lit ni lettres ni mots : il lit des tokens, des morceaux de mots numérotés. « Explique-moi comment se forme un arc-en-ciel » devient une suite d'une dizaine de nombres. Tout ce que vous collez dans un prompt, nom de client compris, passe par ce découpage sur les serveurs : les bons réflexes sont dans mon article sur la protection des données avec l'IA.
Lecture du prompt d'un bloc
Le modèle est trop gros pour une seule puce : il est réparti sur tout un groupe d'accélérateurs qui travaillent ensemble. Le groupe lit d'abord en une seule passe le prompt, l'historique de la conversation et les consignes système. Plus le prompt est long, plus la lecture prend de temps.
Génération token après token
La réponse sort ensuite un token à la fois. Chaque nouveau token demande un passage complet à travers des milliards de paramètres. Le serveur l'envoie aussitôt : la réponse s'écrit sous vos yeux parce qu'elle se calcule sous vos yeux.
Combien de temps prend chaque étape du trajet ?
Le temps de réponse d'une IA se partage très inégalement entre le réseau et le calcul.
| Étape | Durée | Statut |
|---|---|---|
| Wi-Fi jusqu'à la box | 5 à 6 ms aller-retour | mesuré |
| Jusqu'au portier Cloudflare à Paris | 14 à 17 ms aller-retour | mesuré |
| Traversée de l'Atlantique | environ 33 ms dans un sens | calculé (6 600 km à 200 000 km/s) |
| Réseau complet, aller et retour | de l'ordre de 100 ms | estimé |
| Accueil, contrôles, file d'attente | de quelques ms à plusieurs secondes | variable selon l'affluence |
| Lecture du prompt et premier token | souvent moins d'une seconde | ordre de grandeur |
| Génération d'un paragraphe complet | quelques secondes | ordre de grandeur |
Les durées de calcul varient selon le modèle choisi, la longueur du prompt et l'affluence : je les donne comme ordres de grandeur, pas comme des mesures. Un modèle qui « réfléchit » avant de répondre ajoute plusieurs secondes, voire plusieurs minutes.
Vos données traversent l'Atlantique : faut-il s'inquiéter ?
Un prompt envoyé à Claude ou à ChatGPT depuis une offre grand public est traité, dans la très grande majorité des cas, sur des serveurs situés aux États-Unis, par une entreprise soumise au droit américain. Le chiffrement protège le trajet, pas la destination : le prestataire lit votre texte pour vous répondre.
Pour une TPE ou une PME, la conséquence est pratique : ne collez pas dans un chatbot grand public un contrat, un fichier client ou des données de santé sans offre professionnelle et sans avoir vérifié les paramètres de conservation et d'entraînement. Je détaille les options dans mon panorama des solutions IA compatibles RGPD. Le sujet de la souveraineté a d'ailleurs été au coeur de l'audition de Google, OpenAI et Anthropic au Sénat.
3 idées reçues sur le trajet d'un prompt
- « L'IA est dans mon ordinateur. » Faux pour ChatGPT et Claude : votre poste n'affiche que la conversation, tout le calcul se fait à des milliers de kilomètres.
- « Internet passe par les satellites. » Faux pour l'essentiel : les câbles sous-marins portent la quasi-totalité du trafic entre continents.
- « Une réponse lente vient d'une connexion lente. » Rarement : le réseau pèse de l'ordre d'un dixième de seconde, le calcul et la file d'attente font le reste.
"Formez-vous à l'IA avant qu'elle ne vous réforme"
Comment mesurer vous-même le trajet de vos prompts
Le trajet vers les serveurs de l'IA se mesure en trois commandes, sans rien installer.
- Ouvrez un terminal : PowerShell sous Windows, Terminal sous macOS.
- Tapez
tracert claude.ai(Windows) outraceroute claude.ai(macOS) : chaque ligne est un routeur traversé, avec trois temps d'aller-retour. - Tapez
curl -I https://claude.aiet repérez la ligneCF-RAY: les trois lettres finales désignent la ville du portier qui vous répond.
Le même exercice fonctionne avec chatgpt.com. Je recommande l'exercice à toute équipe qui démarre avec l'IA : voir le nom d'une ville s'afficher rend très concret le fait qu'une IA « dans le cloud » vit dans des bâtiments bien réels. Pour aller plus loin sur le choix des outils selon vos contraintes, ma méthode d'audit IA en PME consacre une étape entière aux données.
Questions fréquentes
Où sont les serveurs de l'IA Claude ?
Les serveurs qui font tourner Claude se trouvent très probablement aux États-Unis, chez Google Cloud, Amazon Web Services et Microsoft Azure, en attendant les centres construits avec Fluidstack au Texas et dans l'État de New York. Anthropic ne publie pas quel centre traite quelle demande. Le serveur qui répond en France n'est qu'un portier Cloudflare situé à Paris.
Mon prompt passe-t-il par un satellite ?
Non, sauf connexion Starlink, et même dans ce cas le prompt redescend vers une station au sol avant de reprendre les câbles. La quasi-totalité du trafic entre l'Europe et les États-Unis circule dans des câbles sous-marins en fibre optique, comme Dunant (Vendée vers Virginie) ou Amitié (Gironde vers Massachusetts).
Combien de temps met un prompt pour traverser l'Atlantique ?
Environ 33 millisecondes dans un sens pour 6 600 km de câble, car la lumière circule à environ 200 000 km/s dans la fibre. Le trajet réseau complet, aller et retour, reste de l'ordre du dixième de seconde. Le délai ressenti vient surtout du calcul du modèle et de la file d'attente.
Pourquoi la réponse de l'IA s'affiche-t-elle mot par mot ?
Le modèle produit sa réponse un token à la fois, chaque token demandant un passage complet à travers le réseau de neurones. Le serveur envoie chaque morceau dès qu'il est prêt, en flux continu, au lieu d'attendre la fin. Vous lisez donc la réponse pendant qu'elle se calcule.
Qu'est-ce qu'un token ?
Un token est un morceau de mot, un signe de ponctuation ou un mot court, converti en nombre pour que le modèle puisse le traiter. Une phrase courte en compte souvent une dizaine. La facturation des API et la longueur maximale d'une conversation se comptent en tokens.
Mes données quittent-elles l'Europe quand j'utilise ChatGPT ou Claude ?
Dans la plupart des offres grand public, oui : le traitement se fait sur des serveurs situés hors de l'Union européenne, principalement aux États-Unis. Le chiffrement protège le contenu pendant le trajet, mais le prestataire le lit pour répondre. Évitez d'y coller des données sensibles sans offre professionnelle adaptée et sans vérifier vos paramètres de confidentialité.
Comment voir le trajet de mes requêtes vers une IA ?
Ouvrez un terminal et tapez tracert claude.ai sous Windows ou traceroute claude.ai sous macOS. La commande liste chaque routeur traversé avec son temps d'aller-retour. La commande curl -I https://claude.ai affiche l'en-tête CF-RAY, dont le suffixe indique la ville du serveur Cloudflare qui vous répond.
Et vous ?
Saviez-vous que vos questions à l'IA traversaient l'Atlantique, et cela change-t-il ce que vous acceptez d'y coller au bureau ? Donnez votre avis en commentaire, je réponds à chaque message.
Aller plus loin
Savoir où partent vos prompts est la première étape d'un usage serein de l'IA en entreprise. Ma formation IA certifiée Qualiopi apprend à votre équipe ce qu'elle peut confier à ChatGPT ou Claude, et avec quels réglages. Si vous voulez d'abord savoir quels outils conviennent à vos données, mon audit IA fait le point sur vos usages actuels.
Christophe Girard
Consultant IA, Formateur & Créateur de Micro-SaaS, Fondateur d'ATLANTICOM
Basé en région nantaise, je crée des logiciels sur mesure et des Micro-SaaS pour les TPE/PME grâce au Vibe-Coding (Cursor, Codex, Claude Code, Lovable). Formations certifiées Qualiopi, audits IA, automatisations et outils internes sur-mesure : je vous aide à remplacer vos fichiers Excel par de vrais outils métier : en jours, pas en mois.
"Avec l'IA, le futur, c'est maintenant !"
- ATLANTICOM